
Qwen 3.5-Omni: il nuovo modello AI che scrive codice dai video
Alibaba alza ulteriormente l’asticella nel campo dell’intelligenza artificiale multimodale con il lancio di Qwen 3.5-Omni, una versione evoluta del proprio modello linguistico capace di comprendere e generare contenuti a partire da testo, immagini, audio e video in modo simultaneo.
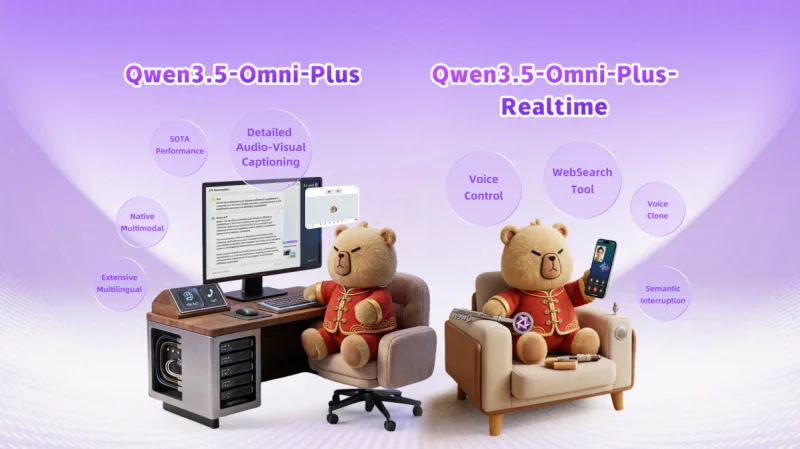
Disponibile nelle varianti Plus, Flash e Light, questo nuovo sistema rappresenta un salto significativo rispetto alla generazione precedente, soprattutto per quanto riguarda la capacità di contesto e le funzionalità avanzate legate alla voce e ai contenuti audiovisivi.
Una finestra di contesto enormemente ampliata
Il miglioramento più evidente riguarda la finestra di contesto, che passa da 32.000 a 256.000 token. Questo consente al modello di gestire quantità di informazioni molto più ampie, arrivando a elaborare fino a 10 ore di audio oppure circa 400 secondi di video in qualità 720p in un’unica sessione.
Anche il riconoscimento vocale ha fatto un balzo in avanti: il sistema ora supporta 113 lingue e dialetti, un incremento notevole rispetto alle 19 lingue disponibili nella versione precedente.
Prestazioni elevate nei benchmark
Secondo i dati diffusi dall’azienda, la versione Plus di Qwen 3.5-Omni ha ottenuto risultati superiori rispetto a Gemini 3.1 Pro in ambiti chiave come riconoscimento, traduzione e dialogo. Nelle attività legate ad audio e video, invece, le prestazioni risultano sostanzialmente equivalenti.
Particolarmente rilevante è il comparto di generazione vocale, dove il modello si distingue per una maggiore stabilità della voce in oltre 20 lingue, superando soluzioni note come ElevenLabs, GPT-Audio e Minimax.
Leggi anche:
Funzioni avanzate e controllo della voce
Tra le funzionalità più interessanti emergono strumenti come la clonazione vocale, il controllo preciso di velocità, volume ed emozione del parlato e la cosiddetta interruzione semantica, che migliora l’interazione naturale tra utente e sistema.
Un ruolo chiave è svolto da ARIA (Adaptive Rate Interleave Alignment), una tecnologia che sincronizza dinamicamente testo e voce, correggendo automaticamente errori come parole mancanti o pronunce poco chiare, soprattutto nei numeri.
La svolta: codice generato dai video
L’aspetto più sorprendente di Qwen 3.5-Omni è la funzione definita Audio-Visual Vibe Coding. In pratica, il modello è in grado di osservare una registrazione dello schermo accompagnata da istruzioni vocali e generare codice funzionante senza alcun input testuale.
Si tratta di un approccio completamente nuovo allo sviluppo software, in cui il linguaggio naturale e il contesto visivo diventano sufficienti per produrre risultati concreti.
Secondo quanto dichiarato da Alibaba, questa capacità non è stata progettata intenzionalmente, ma è emersa durante l’addestramento del modello, rendendola una delle innovazioni più inattese e interessanti nel panorama attuale dell’AI.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Che ne pensi di questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.