
Android Bench 2.0 mette alla prova l’IA: anche i modelli migliori crollano nei test più complessi
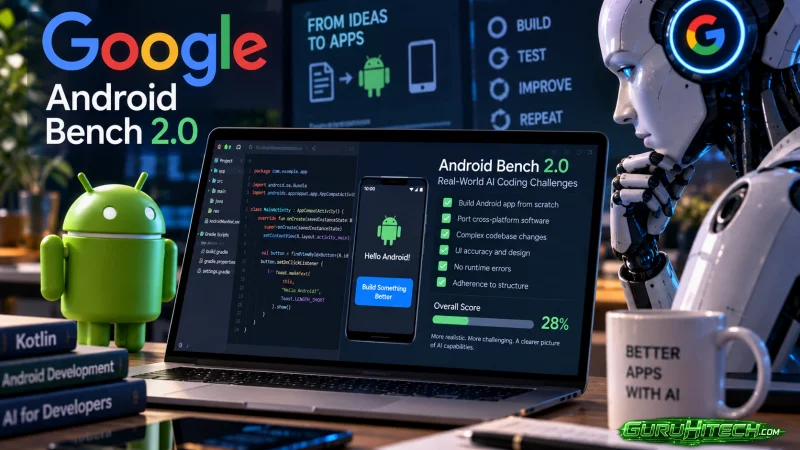
Capire quanto un modello di intelligenza artificiale sia realmente capace di programmare è molto più difficile che verificare se riesce a completare poche righe di codice. Per questo Google ha presentato Android Bench 2.0, una nuova versione del benchmark pensata per valutare i modelli IA attraverso attività di sviluppo Android decisamente più articolate.
La principale novità riguarda proprio la natura delle prove. Al posto di semplici esercizi con un risultato binario, i modelli devono affrontare problemi di ingegneria software complessi, come creare applicazioni partendo da zero oppure effettuare il porting su Android di software nato per altre piattaforme.
Il risultato è un benchmark molto più selettivo. Secondo i dati riportati, modelli che nelle precedenti valutazioni potevano superare facilmente il 90% ottengono punteggi drasticamente inferiori con Android Bench 2.0. Al momento della rilevazione citata, persino GPT-6 Astra di OpenAI, indicato al primo posto, raggiungerebbe un massimo di appena 28%.
Android Bench 2.0 abbandona il semplice sistema pass/fail
Uno dei problemi dei benchmark tradizionali è la difficoltà nel rappresentare il progresso compiuto da un modello durante un’attività complessa.
Nel precedente approccio basato sul risultato pass/fail, una prova poteva essere considerata fallita anche quando l’IA aveva completato correttamente quasi tutto il lavoro. Un modello capace di modificare con successo il 90% di una grande base di codice, per esempio, poteva ricevere lo stesso risultato di uno che non era riuscito praticamente a iniziare se un errore finale impediva di superare il test.
Android Bench 2.0 cerca di superare questo limite introducendo una valutazione continua del progresso.
Non conta più soltanto se l’applicazione supera o meno un controllo finale. Il benchmark prende in considerazione diversi elementi del risultato, tra cui il funzionamento complessivo, la precisione visiva dell’interfaccia, l’assenza di errori e il rispetto della struttura richiesta.
In questo modo diventa possibile distinguere un modello che ha quasi completato correttamente un progetto da uno che si è fermato nelle prime fasi.
L’IA deve creare e convertire vere applicazioni Android
La difficoltà aumenta soprattutto per il tipo di attività richieste.
I modelli vengono messi davanti a problemi più vicini al lavoro di uno sviluppatore: devono essere capaci di comprendere progetti articolati, intervenire su più parti della base di codice e mantenere coerenti architettura e interfaccia dell’applicazione.
Tra le prove previste rientrano la creazione di applicazioni da zero e il porting verso Android di software originariamente sviluppato per altre piattaforme.
Quest’ultimo scenario è particolarmente impegnativo perché non basta tradurre singole istruzioni. Il modello deve comprendere come è strutturato il software originale e adattarlo alle tecnologie, alle API e ai paradigmi utilizzati nell’ambiente Android.
Proprio questo salto di complessità avrebbe fatto emergere differenze considerevoli rispetto ai benchmark precedenti.
Leggi anche:
GPT-6 Astra primo, ma con appena il 28%
Il dato più sorprendente riguarda i punteggi raggiunti dai modelli più avanzati.
Secondo le informazioni riportate, nelle precedenti generazioni di test alcune IA riuscivano a superare il 90%. Con Android Bench 2.0, invece, i risultati diminuiscono drasticamente.
Al momento della classifica citata, il primo posto sarebbe occupato da GPT-6 Astra, il modello di punta di OpenAI, con un risultato massimo di circa 28% delle attività completate.
Un punteggio basso non significa necessariamente che il modello sia diventato meno capace. È soprattutto il benchmark a essere diventato più difficile e a misurare aspetti che i test precedenti riuscivano a catturare solo parzialmente.
Il confronto evidenzierebbe così uno dei limiti degli attuali LLM applicati alla programmazione: possono essere molto efficaci nell’elaborazione locale del codice, ma incontrano maggiori difficoltà quando devono mantenere coerenza durante modifiche architetturali estese e attività di porting complete.
Non basta più valutare il modello isolatamente
Un’altra novità significativa di Android Bench 2.0 è la cosiddetta valutazione agentica.
I moderni assistenti di programmazione non funzionano infatti come semplici modelli ai quali viene sottoposta una domanda. Possono operare come agenti, utilizzare strumenti, consultare file, modificare codice e ripetere autonomamente diverse operazioni prima di arrivare al risultato.
Valutare soltanto il modello sottostante rischia quindi di restituire un’immagine incompleta delle sue capacità.
Con il nuovo approccio, Google considera l’IA insieme al suo ambiente operativo reale, osservando il comportamento dell’agente durante attività più simili a quelle affrontate nello sviluppo software.
Questo consente anche di analizzare aspetti come il consumo di token e il modo in cui il sistema utilizza le risorse disponibili mentre cerca di completare il progetto.
I nuovi benchmark mostrano quanto lavoro resta da fare
Android Bench 2.0 evidenzia una differenza fondamentale tra generare codice e gestire autonomamente un progetto software complesso.
Un modello può essere molto efficace nel completare una funzione, individuare un errore o suggerire una modifica e, allo stesso tempo, incontrare difficoltà quando deve coordinare numerosi cambiamenti mantenendo funzionanti tutte le parti di un’applicazione.
Il drastico calo dei punteggi osservato nel nuovo benchmark diventa quindi più interessante del semplice confronto tra modelli: mostra quanto le prestazioni dell’IA dipendano dalla difficoltà e dal realismo delle prove utilizzate per misurarla.
Con gli agenti IA sempre più presenti nello sviluppo software, benchmark capaci di riprodurre attività complete possono diventare uno strumento importante per distinguere ciò che questi sistemi riescono a fare nelle dimostrazioni da ciò che possono realmente portare a termine in un ambiente di sviluppo professionale.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Ti è piaciuta questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.