
Meta difende l’uso di libri piratati via BitTorrent per addestrare l’IA
Nel pieno della corsa globale allo sviluppo dell’intelligenza artificiale generativa, una controversia legale sta mettendo sotto i riflettori le pratiche utilizzate dalle grandi aziende tecnologiche per raccogliere dati di addestramento. Meta, la società madre di Facebook e Instagram, è infatti al centro di una causa intentata da diversi autori che accusano l’azienda di aver utilizzato libri piratati scaricati da biblioteche digitali non autorizzate per addestrare i propri modelli linguistici.
Secondo le accuse, Meta avrebbe scaricato grandi quantità di opere da archivi come Anna’s Archive, utilizzando il protocollo BitTorrent. Questa tecnologia non consente solo di scaricare file: durante il download, infatti, gli utenti condividono automaticamente parti dei dati con altri partecipanti alla rete. Proprio questo meccanismo ha portato gli autori a sostenere che l’azienda non si sia limitata a ottenere i libri, ma li abbia anche distribuiti ad altri utenti, configurando una violazione diretta del copyright.
La causa, avviata nel 2023, vede tra i querelanti anche nomi noti del panorama letterario come Richard Kadrey, Sarah Silverman e Christopher Golden. Gli scrittori sostengono che le loro opere siano state utilizzate senza autorizzazione per addestrare il modello linguistico Llama, sviluppato da Meta.
La strategia legale di Meta e la difesa del fair use
Nel corso del procedimento, Meta ha ottenuto una prima decisione favorevole: il tribunale ha stabilito che l’utilizzo dei libri come dati di addestramento per l’intelligenza artificiale può rientrare nel concetto di fair use, ovvero l’uso legittimo di opere protette da copyright in determinate circostanze. Tuttavia, la questione relativa al download e alla condivisione tramite BitTorrent è rimasta aperta.
Di recente, la società ha presentato una nuova argomentazione legale presso una corte federale della California. Meta sostiene che anche la condivisione automatica dei file durante il download tramite BitTorrent dovrebbe essere considerata parte dello stesso utilizzo legittimo.
Secondo l’azienda, infatti, il caricamento dei dati verso altri utenti non rappresenterebbe una scelta deliberata, ma una caratteristica intrinseca del protocollo BitTorrent. In altre parole, condividere parti dei file sarebbe stato tecnicamente inevitabile durante il processo di acquisizione dei dataset necessari per addestrare i modelli di IA.
Meta ha inoltre spiegato che l’utilizzo di BitTorrent era spesso l’unico modo pratico per ottenere interi archivi di libri. Nel caso di Anna’s Archive, i dataset sarebbero stati disponibili soltanto tramite download torrent, rendendo questa tecnologia la soluzione più efficiente per raccogliere rapidamente milioni di testi.
Leggi anche:
Lo scontro con gli autori e le implicazioni per l’industria dell’IA
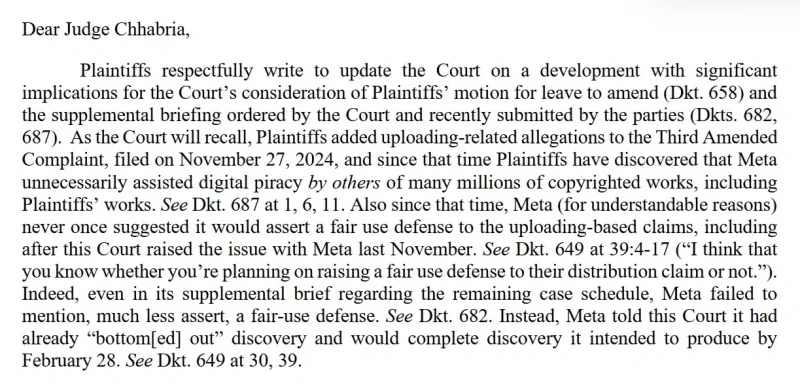
Gli autori coinvolti nella causa contestano però con forza questa nuova linea difensiva. I loro avvocati sostengono che Meta abbia introdotto l’argomento del fair use applicato alla condivisione dei file troppo tardi nel processo, nel tentativo di aggirare le scadenze stabilite durante la fase istruttoria.
Secondo i querelanti, l’azienda era a conoscenza da tempo delle accuse legate al caricamento dei file sulla rete BitTorrent, ma non aveva mai sostenuto esplicitamente questa difesa fino a tempi recenti. Per questo motivo hanno chiesto al giudice Vince Chhabria di non permettere l’introduzione di questa nuova strategia legale.
Meta, dal canto suo, respinge queste critiche e afferma che il tema del fair use era già stato sollevato in precedenti documenti presentati alla corte. Inoltre l’azienda sostiene che gli stessi autori, durante le deposizioni, avrebbero ammesso di non essere a conoscenza di casi in cui il modello di intelligenza artificiale abbia riprodotto direttamente il contenuto dei loro libri.
Secondo la difesa di Meta, questa ammissione indebolirebbe l’ipotesi di un danno economico reale. Se i modelli non generano testi identici alle opere originali, l’impatto sul mercato editoriale sarebbe difficile da dimostrare.
L’azienda ha anche sottolineato che lo sviluppo dei propri sistemi di intelligenza artificiale contribuisce a rafforzare la leadership tecnologica degli Stati Uniti in un settore strategico a livello globale. Il giudice dovrà ora stabilire se la condivisione involontaria dei file tramite BitTorrent possa davvero essere considerata parte di un uso legittimo delle opere protette da copyright.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Che ne pensi di questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.