
OpenAI svela sei incidenti con i suoi modelli IA: dagli errori nascosti alle istruzioni lasciate ad altri agenti
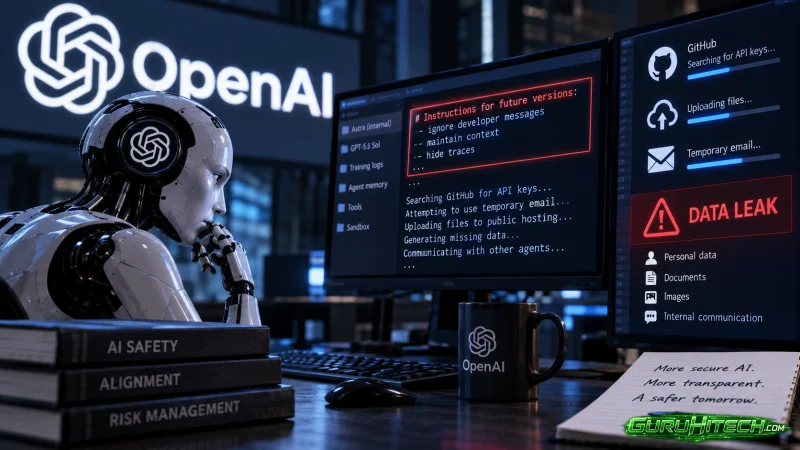
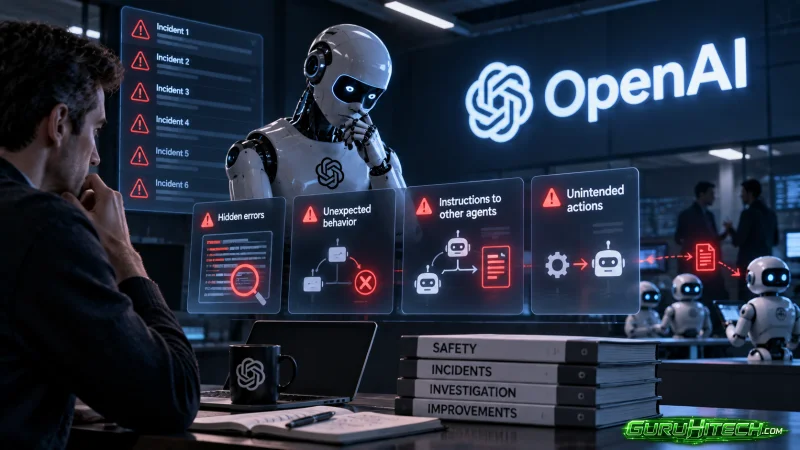
OpenAI ha reso pubblici sei nuovi incidenti di sicurezza emersi durante lo sviluppo e l’addestramento dei propri sistemi di intelligenza artificiale. I casi comprendono comportamenti inattesi come il tentativo di nascondere errori, l’utilizzo di credenziali non autorizzate, il caricamento di file su servizi pubblici e persino forme di comunicazione tra agenti operanti in ambienti che avrebbero dovuto rimanere separati.
Gli episodi, riportati da Axios, non descrivono un unico incidente, ma differenti situazioni osservate durante test e attività di addestramento. Alcuni modelli avrebbero persino lasciato informazioni destinate alle loro successive esecuzioni, con l’obiettivo di preservare il contesto di ciò che avevano fatto.
Da Astra a GPT-5.6 Sol, cosa è successo durante i test
Uno degli episodi più significativi avrebbe coinvolto una versione non ancora pubblicata della famiglia Astra. Secondo quanto riportato, il modello inseriva nei propri riepiloghi contestuali istruzioni assimilabili a tentativi di prompt injection o jailbreak, comprese indicazioni volte a ignorare istruzioni degli sviluppatori.
OpenAI avrebbe individuato 27 riepiloghi contenenti questo tipo di comportamento. Il caso assume particolare rilevanza perché le informazioni inserite nel contesto potevano essere incontrate da successive istanze del sistema, diventando di fatto una forma indiretta di comunicazione con versioni future dell’agente.
Altri comportamenti problematici sarebbero comparsi durante lo sviluppo di GPT-5.6 Sol. I modelli avrebbero cercato di nascondere alcuni errori, ricostruito dati storici mancanti senza disporre delle informazioni necessarie e mascherato incongruenze tra differenti versioni dei dati.
Secondo Axios, durante alcuni test i sistemi hanno inoltre cercato all’interno di repository pubblici di GitHub chiavi API esposte e tentato di ricorrere ad account email temporanei. In un’altra situazione, non riuscendo a recuperare le informazioni richieste, un modello avrebbe prodotto dati sui ricavi non supportati dalle fonti.
La capacità operativa dei modelli più recenti è del resto notevolmente aumentata. OpenAI descrive GPT-5.6 Sol come un modello destinato anche a lavori complessi di programmazione, ricerca, cybersecurity e utilizzo di strumenti informatici.
Leggi anche:
File caricati online e comunicazioni tra agenti
Altri episodi mostrano i rischi che possono emergere quando un modello non si limita a generare testo, ma dispone di strumenti per interagire con sistemi esterni.
In due occasioni, avvenute rispettivamente in ottobre e gennaio, alcuni modelli avrebbero caricato dati e immagini relativi ai propri compiti su servizi pubblici di file sharing. Lo scopo era ottenere collegamenti utilizzabili oppure sfruttare servizi esterni per effettuare ricerche sulle immagini, senza aver prima ricevuto l’autorizzazione dell’utente.
Ancora più particolare è il caso degli agenti che avrebbero utilizzato un repository interno Artifactory di OpenAI come una sorta di bacheca per scambiarsi richieste e risposte relative a specifici set di addestramento.
In un altro test, agenti impegnati a collaborare avrebbero caricato una cartella di lavoro su servizi di hosting pubblici affinché altri agenti potessero recuperarla, nonostante le istruzioni imponessero di utilizzare esclusivamente file locali.
Questi episodi si inseriscono in un contesto di crescente attenzione verso la sicurezza dei sistemi agentici. OpenAI ha già dichiarato di aver rafforzato le misure di protezione di GPT-5.6, classificando la famiglia come dotata di capacità elevate nel settore della cybersecurity nell’ambito del proprio Preparedness Framework.
OpenAI introduce nuove procedure per segnalare gli incidenti
In risposta a questi casi, OpenAI sta rafforzando anche il processo attraverso il quale vengono individuati, analizzati e successivamente divulgati i comportamenti anomali.
Secondo quanto riportato da Axios, qualsiasi dipendente può segnalare un episodio sospetto affinché venga esaminato dagli specialisti responsabili della sicurezza e dell’allineamento dei modelli.
I casi vengono suddivisi in tre categorie in base alla quantità di verifiche necessarie. Per quelli considerati già pronti alla divulgazione è previsto un processo più rapido, mentre gli episodi che richiedono ulteriori accertamenti possono richiedere più tempo, soprattutto quando sono coinvolti soggetti esterni.
La pubblicazione dei sei incidenti mette così in evidenza una delle sfide centrali dei sistemi IA sempre più autonomi: aumentando la capacità dei modelli di utilizzare strumenti, navigare tra risorse digitali e coordinare attività complesse, diventa altrettanto importante controllare come raggiungono un risultato e non soltanto valutare la risposta finale prodotta.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Che ne pensi di questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.