
Alibaba lancia Qwen-Image-2.1: genera e modifica immagini anche con sfondo trasparente
Alibaba amplia la famiglia Qwen con Qwen-Image-2.1, un nuovo modello dedicato alla generazione e alla modifica delle immagini. Presentato il 20 settembre 2026, il sistema riunisce text-to-image ed editing in un’unica architettura e introduce il supporto nativo alla trasparenza RGBA, oltre alla possibilità di lavorare contemporaneamente con un massimo di 10 immagini di riferimento.
Il modello è stato pubblicato insieme ai pesi e al codice necessario per utilizzarlo, rendendo possibile anche l’esecuzione in locale su hardware adeguato. La componente dedicata alla generazione visiva conta 7 miliardi di parametri, una dimensione relativamente compatta rispetto alle capacità offerte.
Qwen-Image-2.1 punta su efficienza e immagini trasparenti
La componente visiva di Qwen-Image-2.1 utilizza un’architettura Single-Stream DiT composta da 32 livelli e circa 7 miliardi di parametri. Alibaba dichiara di aver lavorato sull’efficienza attraverso tecniche come l’attenzione a granularità mista e il riutilizzo della prefix KV cache, con l’obiettivo di ridurre il costo computazionale dell’inferenza.
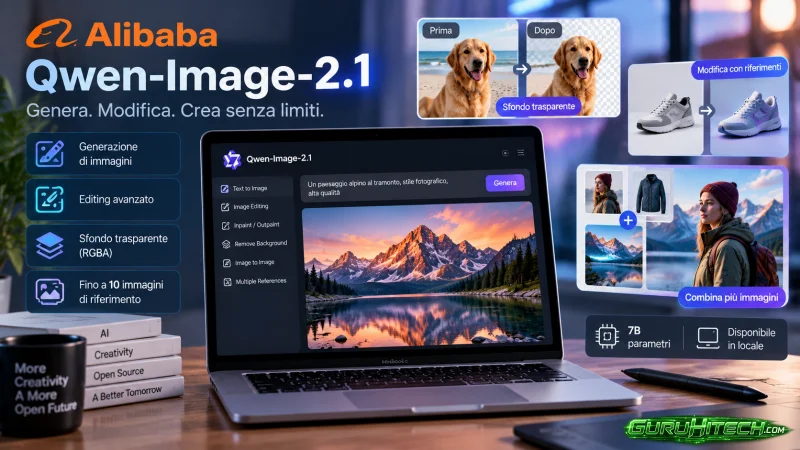
Una delle novità più interessanti è il supporto nativo alle immagini RGBA. Il modello può quindi creare direttamente contenuti con sfondo trasparente, modificare livelli trasparenti oppure estrarre un soggetto da una fotografia mantenendolo come elemento separato.
Questa caratteristica rende il modello particolarmente interessante per compositing, grafica, e-commerce e creazione di asset da utilizzare successivamente all’interno di altri progetti.
Qwen-Image-2.1 supporta inoltre una risoluzione nativa di 2K e diversi rapporti d’aspetto, compresi 1:1, 4:3, 3:4, 3:2, 2:3, 16:9 e 9:16.
Leggi anche:
Fino a 10 immagini di riferimento per modificare una scena
Alibaba ha dedicato particolare attenzione anche all’editing. Qwen-Image-2.1 può utilizzare fino a 10 immagini di riferimento contemporaneamente, combinando soggetti e oggetti provenienti da fonti differenti all’interno di una nuova composizione.
Il modello è progettato per preservare meglio l’identità delle persone durante le trasformazioni e mantenere elementi caratteristici dei prodotti, come forme, texture e scritte.
Per indicare un intervento locale non è necessario affidarsi esclusivamente a una descrizione testuale. L’utente può utilizzare una maschera separata, tracciare cerchi sulle aree interessate oppure aggiungere annotazioni direttamente sull’immagine.
Tra gli esempi mostrati dal team Qwen figurano la composizione di una fotografia di gruppo partendo da ritratti individuali, la creazione di un outfit utilizzando più immagini di riferimento e modifiche localizzate come la rimozione di un orologio, il cambiamento del colore dei capelli o la sostituzione dell’abbigliamento. Il modello può essere impiegato anche per panorami e storyboard.
Migliorano testo, texture e illuminazione dei ritratti
Con questa versione il team Qwen dichiara miglioramenti anche nella resa delle texture, nella generazione tipografica, nell’illuminazione dei ritratti e nella riproduzione dei dettagli più piccoli.
Il sistema utilizza inoltre Qwen3-VL 8B come text encoder multimodale, incaricato di trasformare istruzioni testuali e immagini di riferimento in una rappresentazione utilizzabile dal modello generativo. Per la gestione della trasparenza è presente un autoencoder RGBA a 64 canali.
Alibaba ha pubblicato anche propri confronti prestazionali con modelli concorrenti. Questi risultati vanno però interpretati come benchmark forniti dallo stesso sviluppatore, e non come una valutazione indipendente definitiva della qualità relativa dei diversi sistemi.
Qwen-Image-2.1 è disponibile su GitHub e Hugging Face
Qwen-Image-2.1 è già disponibile pubblicamente attraverso GitHub e Hugging Face. I pesi sono distribuiti con licenza Qwen Research, quindi è importante verificarne le condizioni prima di utilizzare il modello al di fuori di attività compatibili con tale licenza.
Al debutto sono già disponibili integrazioni con strumenti e framework come Diffusers, ComfyUI, vLLM-Omni e SGLang, rendendo più semplice sperimentare il modello senza dover costruire da zero l’intera pipeline.
La combinazione tra 7 miliardi di parametri, generazione ed editing unificati, trasparenza RGBA e supporto a numerosi riferimenti rende Qwen-Image-2.1 una proposta particolarmente flessibile per chi vuole sperimentare localmente con la generazione visiva senza dipendere esclusivamente da servizi proprietari accessibili tramite cloud.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Ti è piaciuta questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.