
RESON accelera di 10 volte i test dei modelli di riconoscimento vocale
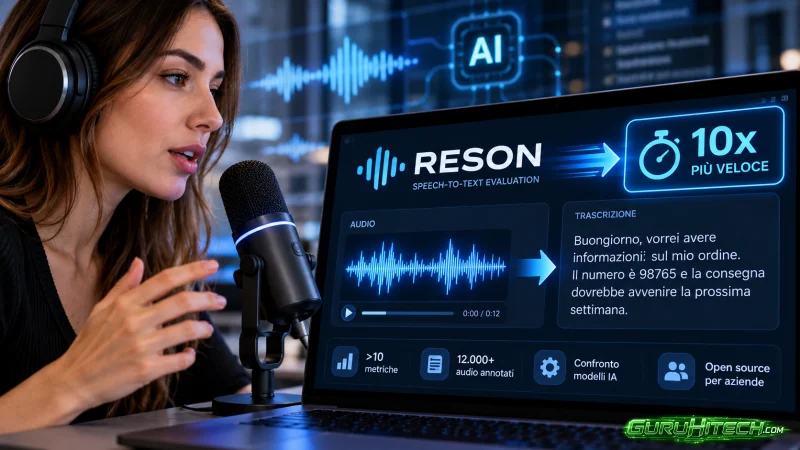
MWS AI ha presentato uno strumento open source che confronta precisione ed errori dei sistemi speech-to-text, riducendo analisi di diverse ore a pochi minuti.
Valutare la precisione di un sistema di riconoscimento vocale basato sull’intelligenza artificiale può richiedere un lavoro considerevole, soprattutto quando devono essere confrontate più versioni dello stesso modello. MWS AI, società appartenente a MTS Web Services, ha sviluppato RESON proprio per semplificare questo processo.
Si tratta di uno strumento aperto progettato per misurare la qualità dei modelli speech-to-text e confrontarne rapidamente i risultati. Secondo MWS AI, un’analisi che in precedenza poteva richiedere diverse ore può essere completata con RESON in appena 10-15 minuti.
RESON utilizza oltre 10 metriche per valutare il riconoscimento vocale
Il sistema non si limita a stabilire genericamente se una trascrizione sia corretta. RESON supporta più di 10 metriche attraverso le quali gli sviluppatori possono analizzare differenti aspetti del comportamento di un modello.
Tra queste rientrano il numero di errori commessi sulle parole, quelli relativi ai singoli caratteri e indicatori dedicati alla corretta identificazione di termini poco frequenti. Quest’ultimo aspetto può diventare particolarmente importante nelle applicazioni professionali, dove il sistema deve comprendere correttamente nomi di aziende, prodotti, servizi, marchi o anglicismi.
MWS AI ha inoltre sviluppato una propria metrica pensata per individuare termini che incidono poco sul valore generale di accuratezza, ma possono essere determinanti per lo specifico utilizzo del sistema. Un modello potrebbe infatti ottenere risultati complessivamente molto buoni e, allo stesso tempo, continuare a sbagliare proprio le parole più importanti per un determinato settore.
Leggi anche:
Le aziende possono utilizzare RESON anche nei propri sistemi interni
RESON è stato progettato per integrarsi nei processi di sviluppo già esistenti. Le aziende possono installarlo nella propria infrastruttura e utilizzarlo anche all’interno di ambienti chiusi, caratteristica utile quando registrazioni e dati non possono essere trasferiti verso servizi esterni.
Lo strumento si rivolge sia ai team che sviluppano direttamente tecnologie di riconoscimento vocale, sia alle organizzazioni che devono scegliere tra soluzioni realizzate da fornitori differenti.
Insieme a RESON, MWS AI ha pubblicato anche un dataset aperto composto da oltre 12.000 registrazioni audio annotate, per una durata complessiva di circa 38 ore.
Il materiale cerca di riprodurre situazioni tipiche delle comunicazioni vocali e dei contact center. Sono presenti richieste rivolte all’assistenza, notifiche automatiche, normali conversazioni telefoniche e frasi contenenti informazioni particolarmente delicate per un sistema speech-to-text, come numeri di telefono, conti, date e importi.
Il dataset comprende sia registrazioni relativamente pulite sia audio caratterizzati da rumore e conversazioni in sottofondo, permettendo quindi di verificare il comportamento dei modelli anche in condizioni meno favorevoli.
GigaAM v3 ottiene il risultato migliore nel confronto
MWS AI ha utilizzato il sistema anche per confrontare diversi modelli aperti sviluppati da Sber, Alpha Cephei, Nvidia e OpenAI, concentrandosi in particolare sul Word Error Rate (WER), una metrica comunemente impiegata per misurare gli errori nella trascrizione automatica.
Nel confronto riportato dall’azienda, GigaAM v3 di Sber ha ottenuto il miglior risultato medio, con un tasso di errore sulle parole del 7,42%. Al secondo posto si è classificato Vosk di Alpha Cephei con l’11,07%.
Più elevati i valori registrati dai sistemi Nvidia presi in esame: Parakeet ha raggiunto il 15,83%, mentre Nemotron si è fermato al 25,52%. Nei test condotti sul dataset utilizzato da MWS AI, GigaAM v3 ha quindi commesso meno della metà degli errori registrati da Parakeet e meno di un terzo rispetto a Nemotron.
Questi risultati vanno comunque interpretati nel contesto dello specifico dataset e della metodologia adottata: le prestazioni di un sistema di riconoscimento vocale possono cambiare in funzione della lingua, della qualità dell’audio, del vocabolario e dello scenario operativo.
Da strumento interno a progetto aperto
RESON era nato inizialmente come soluzione destinata alle esigenze interne del team MWS AI. In precedenza, secondo quanto spiegato dall’azienda, la valutazione richiedeva diversi strumenti: le metriche venivano calcolate separatamente, gli errori analizzati attraverso altri sistemi e i risultati successivamente riuniti manualmente.
La nuova piattaforma concentra queste attività all’interno di un unico ambiente. Secondo Alexander Shevchenko, responsabile del team di riconoscimento vocale di MWS AI, proprio questa integrazione avrebbe permesso di ridurre da diverse ore a circa 10-15 minuti il tempo necessario per alcune analisi.
Rendere RESON e il relativo dataset disponibili pubblicamente può inoltre facilitare confronti più uniformi tra tecnologie differenti. Per sviluppatori e aziende diventa così possibile analizzare non soltanto quale modello commetta meno errori in generale, ma anche dove e perché il riconoscimento vocale fallisce, un’informazione spesso molto più importante del semplice punteggio finale.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Che ne pensi di questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.