
Le intelligenze artificiali al volante di una vera Toyota Corolla: ecco come è andato il test
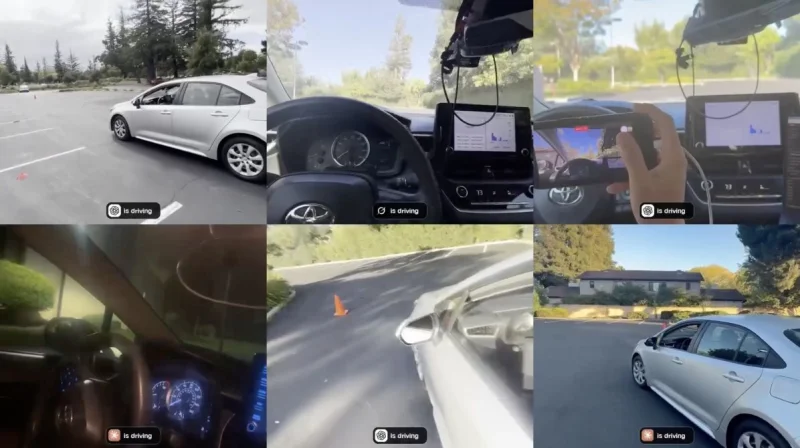
Le intelligenze artificiali possono scrivere codice, analizzare immagini e risolvere problemi complessi, ma cosa succede quando devono guidare un’automobile nel mondo reale? È la domanda alla base di DrivingBench, un nuovo benchmark che ha messo alla prova diversi modelli linguistici di grandi dimensioni (LLM) al volante di una Toyota Corolla del 2022.
L’esperimento ha coinvolto modelli di OpenAI, Anthropic e xAI, chiamati a completare un percorso delimitato da coni in un parcheggio chiuso. Per garantire la sicurezza, una persona è rimasta al posto di guida, pronta a intervenire in caso di necessità.
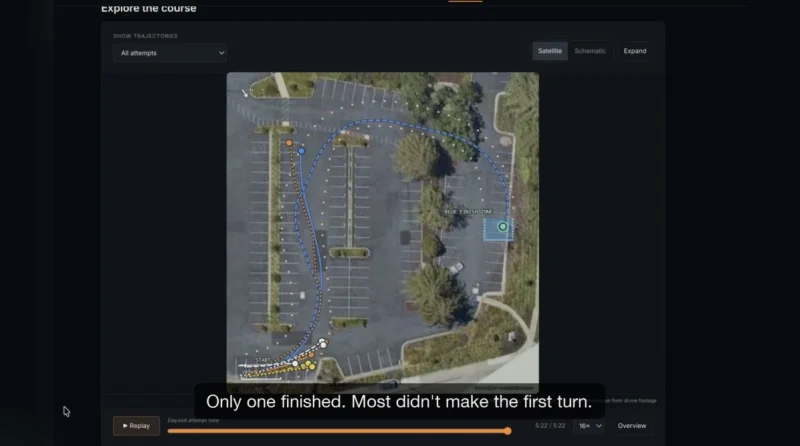
I risultati hanno evidenziato differenze significative tra i sistemi testati. Mentre alcuni modelli non sono riusciti a superare la prima curva, uno ha completato l’intero tracciato al secondo tentativo.
Come funziona DrivingBench: l’IA controlla sterzo e velocità
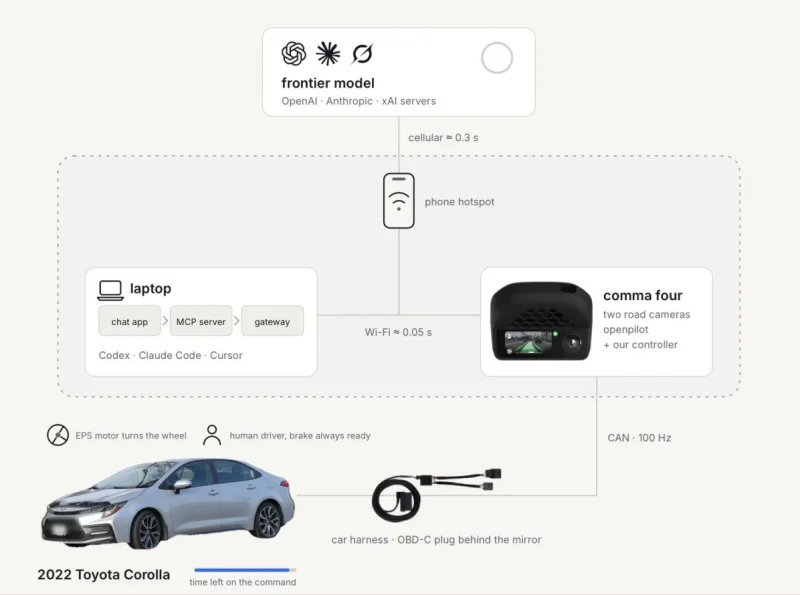
Per consentire ai modelli di intelligenza artificiale di controllare un’automobile reale, i ricercatori hanno utilizzato un dispositivo Comma Four, collegato al bus CAN della Toyota Corolla.
Il sistema permetteva all’IA di ricevere immagini dalle telecamere e informazioni telemetriche del veicolo. Attraverso il protocollo aperto Model Context Protocol (MCP), ogni modello poteva quindi inviare comandi relativi alla velocità, alla durata del movimento e all’angolo di sterzata.
Una caratteristica importante dell’architettura era la possibilità di modificare un comando prima che la sua esecuzione fosse terminata. In questo modo, i modelli potevano correggere la traiettoria durante la marcia, anziché attendere il completamento di ogni singola manovra.
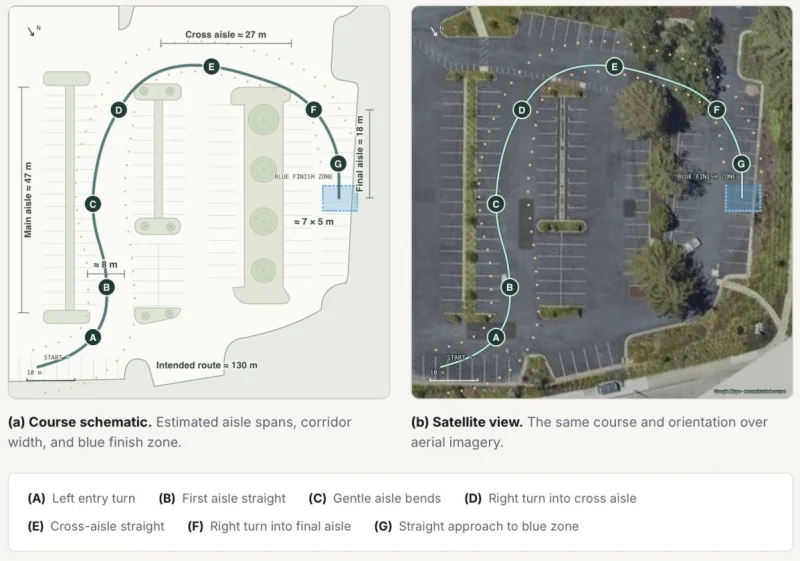
Il percorso di prova comprendeva rettilinei, curve a destra e a sinistra, tratti curvilinei e una manovra di parcheggio. Ogni modello aveva a disposizione fino a tre tentativi sullo stesso tracciato.
La difficoltà principale, tuttavia, non riguardava tanto il controllo dello sterzo quanto la capacità di interpretare correttamente l’ambiente circostante. Diversi modelli hanno commesso errori già alla prima curva, individuando in modo sbagliato il lato del veicolo su cui si trovava la fila di coni.
Leggi anche:
GPT-6 Astra completa il percorso al secondo tentativo
Secondo i risultati riportati dagli autori di DrivingBench, GPT-6 Astra ha ottenuto il risultato più significativo dell’esperimento.
Al primo tentativo, il modello è riuscito a percorrere circa metà del tracciato. Durante la seconda prova, invece, ha completato l’intero percorso in circa cinque minuti.
Anche Claude Fable 5.1 ha mostrato progressi tra un tentativo e l’altro, riuscendo però a completare soltanto metà del percorso al terzo tentativo. Gli altri modelli testati si sono fermati già alla prima curva.
I ricercatori hanno inoltre osservato alcuni cambiamenti nel comportamento dei sistemi dopo gli errori iniziali. Astra, per esempio, ha ridotto la velocità e ha iniziato a utilizzare più frequentemente l’angolo massimo di sterzata disponibile.
Fable ha invece modificato la propria interpretazione delle manovre sulla base dell’esperienza acquisita durante le prove precedenti.
Questi comportamenti suggeriscono una capacità di adattare le strategie di guida ai risultati dei tentativi precedenti, senza però dimostrare necessariamente un apprendimento permanente o una modifica dei parametri dei modelli.
Sicurezza e limiti del test: l’IA è ancora lontana dalla guida autonoma
L’intero esperimento si è svolto in un ambiente controllato, con precise limitazioni per ridurre i rischi.
La velocità operativa era compresa tra 0,5 e 3,5 m/s, equivalenti a circa 1,8-12,6 km/h. Era inoltre prevista una soglia di emergenza a 6 m/s, pari a circa 21,6 km/h.
La presenza di una persona al posto di guida rappresentava un’ulteriore misura di sicurezza, necessaria per intervenire qualora il sistema avesse eseguito una manovra pericolosa.
Gli autori sottolineano che DrivingBench non può ancora essere considerato una valutazione completa delle capacità di guida autonoma dei modelli linguistici. Il numero limitato di prove e le caratteristiche relativamente semplici del percorso non permettono di stabilire come questi sistemi si comporterebbero nel traffico reale.
Per la prossima versione del benchmark, i ricercatori intendono aumentare il numero di test, introdurre differenti livelli di ragionamento e rendere il tracciato più complesso.
L’esperimento mostra comunque quanto sia difficile trasferire le capacità di ragionamento di un’intelligenza artificiale dal mondo digitale a quello fisico, dove una percezione errata dell’ambiente può compromettere anche una manovra apparentemente semplice.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Ti è piaciuta questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.