
NVIDIA Nemotron 3.5 Transcribe: l’IA gratis trascrive 40 lingue
NVIDIA entra ancora più decisamente nel settore della trascrizione automatica con Nemotron 3.5 Transcribe, un nuovo modello di intelligenza artificiale gratuito e con pesi aperti capace di trasformare registrazioni vocali in testo in 40 lingue, compreso l’italiano. Presentato il 28 ottobre 2026, il sistema non si limita a riconoscere le parole: può tradurre il parlato, distinguere diversi interlocutori e seguire istruzioni formulate in linguaggio naturale per adattare il risultato alle esigenze di chi lo utilizza.
L’annuncio è interessante per chi registra riunioni, interviste, lezioni e podcast, ma anche per gli sviluppatori che vogliono integrare il riconoscimento vocale nei propri software. C’è però una distinzione fondamentale: gratuito non significa immediatamente utilizzabile su qualsiasi computer. Nemotron 3.5 Transcribe è un modello destinato soprattutto a sviluppatori e organizzazioni, e per eseguirlo localmente servono risorse hardware importanti.
Come funziona Nemotron 3.5 Transcribe
Il nuovo sistema appartiene alla famiglia Nemotron e combina riconoscimento del parlato e capacità linguistiche avanzate. A differenza di un semplice servizio che restituisce una trascrizione, permette di specificare il risultato desiderato attraverso un’istruzione testuale. Si può chiedere una trascrizione letterale, che conservi esitazioni e ripetizioni, oppure una versione più pulita, adatta per esempio a preparare sottotitoli o appunti.
Una funzione particolarmente utile è il riconoscimento contestuale. Lo sviluppatore può fornire al modello termini specialistici, nomi propri o vocaboli tecnici che potrebbero essere difficili da riconoscere correttamente. In questo modo, almeno nelle condizioni previste dal sistema, la trascrizione può essere adattata al linguaggio di un settore professionale.
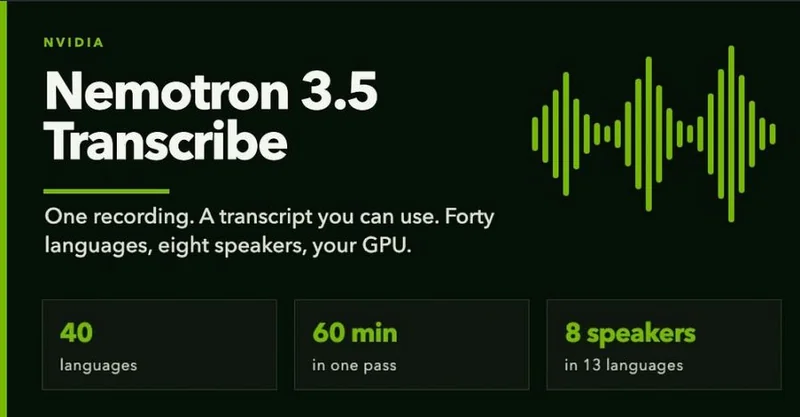
NVIDIA indica una durata massima di un’ora per registrazione. Questo rende il modello adatto a molti colloqui, lezioni e interventi registrati, ma non elimina la necessità di dividere file più lunghi o di verificare il testo prodotto.
Quaranta lingue e traduzione del parlato
La capacità di trascrivere 40 lingue è uno dei punti principali del lancio. Tra gli idiomi supportati figurano inglese, italiano, spagnolo, francese, tedesco, portoghese, giapponese e numerose altre lingue. La qualità, tuttavia, non è necessariamente identica per tutte: NVIDIA distingue diversi livelli di supporto e segnala che alcuni casi possono beneficiare di ulteriori ottimizzazioni.
Nemotron 3.5 Transcribe può inoltre eseguire la traduzione del parlato tra l’inglese e 31 altre lingue, in entrambe le direzioni. Non significa che tutte le possibili coppie fra le 40 lingue siano disponibili direttamente: l’inglese rappresenta il riferimento per le combinazioni di traduzione dichiarate.
Per chi lavora con contenuti internazionali, l’idea è poter partire da un file audio e ottenere una trascrizione o una traduzione senza dover assemblare necessariamente più modelli separati. Resta comunque consigliabile una revisione umana quando il risultato contiene terminologia specialistica, nomi, cifre o passaggi ambigui.
Riconosce fino a otto persone nella stessa registrazione
Un’altra funzione rilevante è la diarizzazione dei parlanti, ossia la capacità di separare gli interventi delle diverse voci. NVIDIA dichiara che il modello può distinguere fino a otto interlocutori all’interno di una registrazione e associare le parole a etichette che identificano chi sta parlando.
Questa funzione può tornare utile durante riunioni aziendali, interviste collettive, podcast e conversazioni registrate. Invece di ottenere un unico blocco di testo, lo sviluppatore può richiedere un risultato organizzato per interlocutore, con riferimenti temporali alle parole.
È importante precisare che distinguere le voci non significa riconoscere l’identità reale delle persone. Il modello assegna etichette ai parlanti, ma non determina automaticamente nomi e cognomi. Inoltre, le funzionalità avanzate di attribuzione dei parlanti non hanno lo stesso livello di supporto in tutte le 40 lingue: la documentazione indica un insieme più ristretto di lingue per questa capacità.
Può anche rispondere a domande sul contenuto dell’audio
Nemotron 3.5 Transcribe non è progettato soltanto per scrivere ciò che ascolta. NVIDIA presenta anche capacità di comprensione dell’audio, con la possibilità di formulare domande sul contenuto di una registrazione. Per esempio, uno sviluppatore potrebbe voler ricavare informazioni da una conversazione o identificare determinati argomenti.
Questa funzione richiede però cautela: la documentazione disponibile indica che la valutazione delle risposte a domande sull’audio riguarda soprattutto l’inglese. Non bisogna quindi dare per scontato che la stessa affidabilità sia garantita in ogni lingua supportata per la trascrizione.
Come accade con altri modelli generativi, anche un sistema specializzato nell’audio può commettere errori o produrre risposte non pienamente giustificate dalla registrazione. Se il contenuto riguarda informazioni mediche, legali o decisioni economiche, il testo originale e le risposte generate devono essere controllati.
Leggi anche:
È davvero gratuito? Ecco dove si può scaricare
NVIDIA distribuisce il modello con una licenza OpenMDW-1.1 che ne permette l’utilizzo anche in ambito commerciale, nel rispetto delle relative condizioni. I pesi sono disponibili attraverso piattaforme dedicate agli sviluppatori, tra cui Hugging Face. È un approccio diverso da quello dei servizi che richiedono necessariamente un abbonamento per ogni ora di audio elaborato.
Questo, però, non vuol dire che l’esecuzione sia priva di costi. Chi utilizza un server cloud può dover pagare per la capacità di calcolo, mentre chi vuole installare il modello in locale deve disporre di una scheda grafica compatibile e di sufficiente memoria. Anche eventuali servizi che ospitano il modello possono applicare tariffe proprie.
Al momento del lancio, Nemotron 3.5 Transcribe non è un programma desktop con una semplice interfaccia grafica pronta per tutti. Gli sviluppatori possono integrarlo tramite strumenti software e servizi di inferenza, mentre gli utenti meno esperti potrebbero preferire una dimostrazione online o attendere applicazioni che lo adottino.
Requisiti hardware: non basta una normale scheda video
Il modello è basato su un’architettura Mixture of Experts, con circa 34 miliardi di parametri complessivi e poco più di 4 miliardi attivi durante l’elaborazione. Questa struttura consente di ridurre il lavoro necessario rispetto all’attivazione simultanea di tutti i parametri, ma non rende il modello leggero come una comune applicazione di trascrizione.
La configurazione di riferimento pubblicata per l’esecuzione locale utilizza una NVIDIA H100 con 80 GB di memoria. Sono previste anche varianti a precisione ridotta, comprese versioni che possono ampliare la compatibilità con hardware come RTX 5090, ma disponibilità effettiva e strumenti di esecuzione devono essere verificati prima di pianificare un’installazione.
Per molti utenti domestici, quindi, la strada più semplice potrebbe essere l’utilizzo di un servizio ospitato da terzi. Chi invece possiede un computer con GPU di fascia media non dovrebbe presumere di poter eseguire senza problemi il modello completo.
Niente trascrizione in diretta: il limite da conoscere
Un aspetto importante rischia di passare inosservato dietro ai numeri del lancio: Nemotron 3.5 Transcribe lavora su registrazioni già effettuate. Non è stato progettato come sistema di riconoscimento vocale in streaming per generare sottotitoli mentre una persona parla.
Questo significa che non è, da solo, il sostituto diretto delle funzioni di dettatura in tempo reale o dei sottotitoli live delle videoconferenze. NVIDIA sviluppa anche altri modelli vocali, compresi sistemi ottimizzati per l’elaborazione continua dell’audio, ma si tratta di prodotti con caratteristiche differenti.
Per utilizzare Nemotron 3.5 Transcribe in un flusso di lavoro, la soluzione più naturale è quindi registrare l’audio, inviarlo al modello e successivamente ottenere il testo o la traduzione richiesta.
Granary v2: oltre 463.000 ore di dati vocali
Insieme al nuovo modello, NVIDIA ha presentato anche Granary v2, una raccolta di risorse per l’addestramento dei sistemi vocali che comprende riferimenti a circa 463.000 ore di parlato in 48 lingue. L’obiettivo è mettere a disposizione degli sviluppatori dati e procedure per migliorare modelli destinati a settori e contesti specifici.
La raccolta non equivale necessariamente a un unico archivio audio liberamente riutilizzabile senza condizioni: i materiali provengono da fonti differenti e possono essere soggetti alle rispettive licenze. Prima di utilizzarli in progetti commerciali è quindi necessario controllare i termini applicabili.
NVIDIA ha illustrato anche un caso di personalizzazione del riconoscimento vocale in ambito medico, con una riduzione degli errori riportata nei propri test. È un esempio delle potenzialità dell’addestramento mirato, ma non dimostra che il modello standard sia automaticamente adatto a trascrivere ogni consulto clinico senza revisione.
Meglio di Whisper e degli altri sistemi di trascrizione?
NVIDIA sostiene che Nemotron 3.5 Transcribe ottenga risultati molto competitivi nei benchmark di riconoscimento vocale, inclusa la classifica Open ASR Leaderboard di Hugging Face. Le valutazioni pubblicate indicano prestazioni elevate su diversi test, ma i risultati vanno interpretati nel loro contesto.
Un benchmark misura la qualità su specifici insiemi di registrazioni. Nell’uso reale, rumore di fondo, microfoni scadenti, accenti regionali, voci sovrapposte e termini insoliti possono cambiare sensibilmente la precisione. Inoltre, modelli più piccoli come Whisper o altre soluzioni leggere possono risultare preferibili quando contano soprattutto consumi ridotti, semplicità d’installazione e compatibilità con computer comuni.
La novità più interessante di Nemotron 3.5 Transcribe non è quindi soltanto la quantità di lingue supportate. È l’unione, nello stesso modello, di trascrizione, traduzione, attribuzione dei parlanti e istruzioni contestuali. Per sviluppatori, aziende e ricercatori può rappresentare una base flessibile su cui costruire strumenti vocali personalizzati, purché si tengano presenti i requisiti hardware e i limiti dichiarati.
Ti potrebbe interessare:
Segui guruhitech su:
- Google News: bit.ly/gurugooglenews
- Telegram: t.me/guruhitech
- Facebook: facebook.com/guruhitechfb
- Instagram: instagram.com/guruhitech_official/
- X (Twitter): x.com/guruhitech1
- Bluesky: bsky.app/profile/guruhitech.bsky.social
- Rumble: rumble.com/user/guruhitech
- VKontakte: vk.com/guruhitech
- MeWe: mewe.com/i/guruhitech
- Skype: live:.cid.d4cf3836b772da8a
- WhatsApp: bit.ly/whatsappguruhitech
Esprimi il tuo parere!
Ti è piaciuta questa notizia? Lascia un commento nell’apposita sezione che trovi più in basso e se ti va, iscriviti alla newsletter.
Per qualsiasi domanda, informazione o assistenza nel mondo della tecnologia, puoi inviare una email all’indirizzo [email protected].
Scopri di più da GuruHiTech
Abbonati per ricevere gli ultimi articoli inviati alla tua e-mail.